
Advantages
Massive Scale
Features 10 million molecules, setting a new industry benchmark.
Redundancy-Free & High Purity
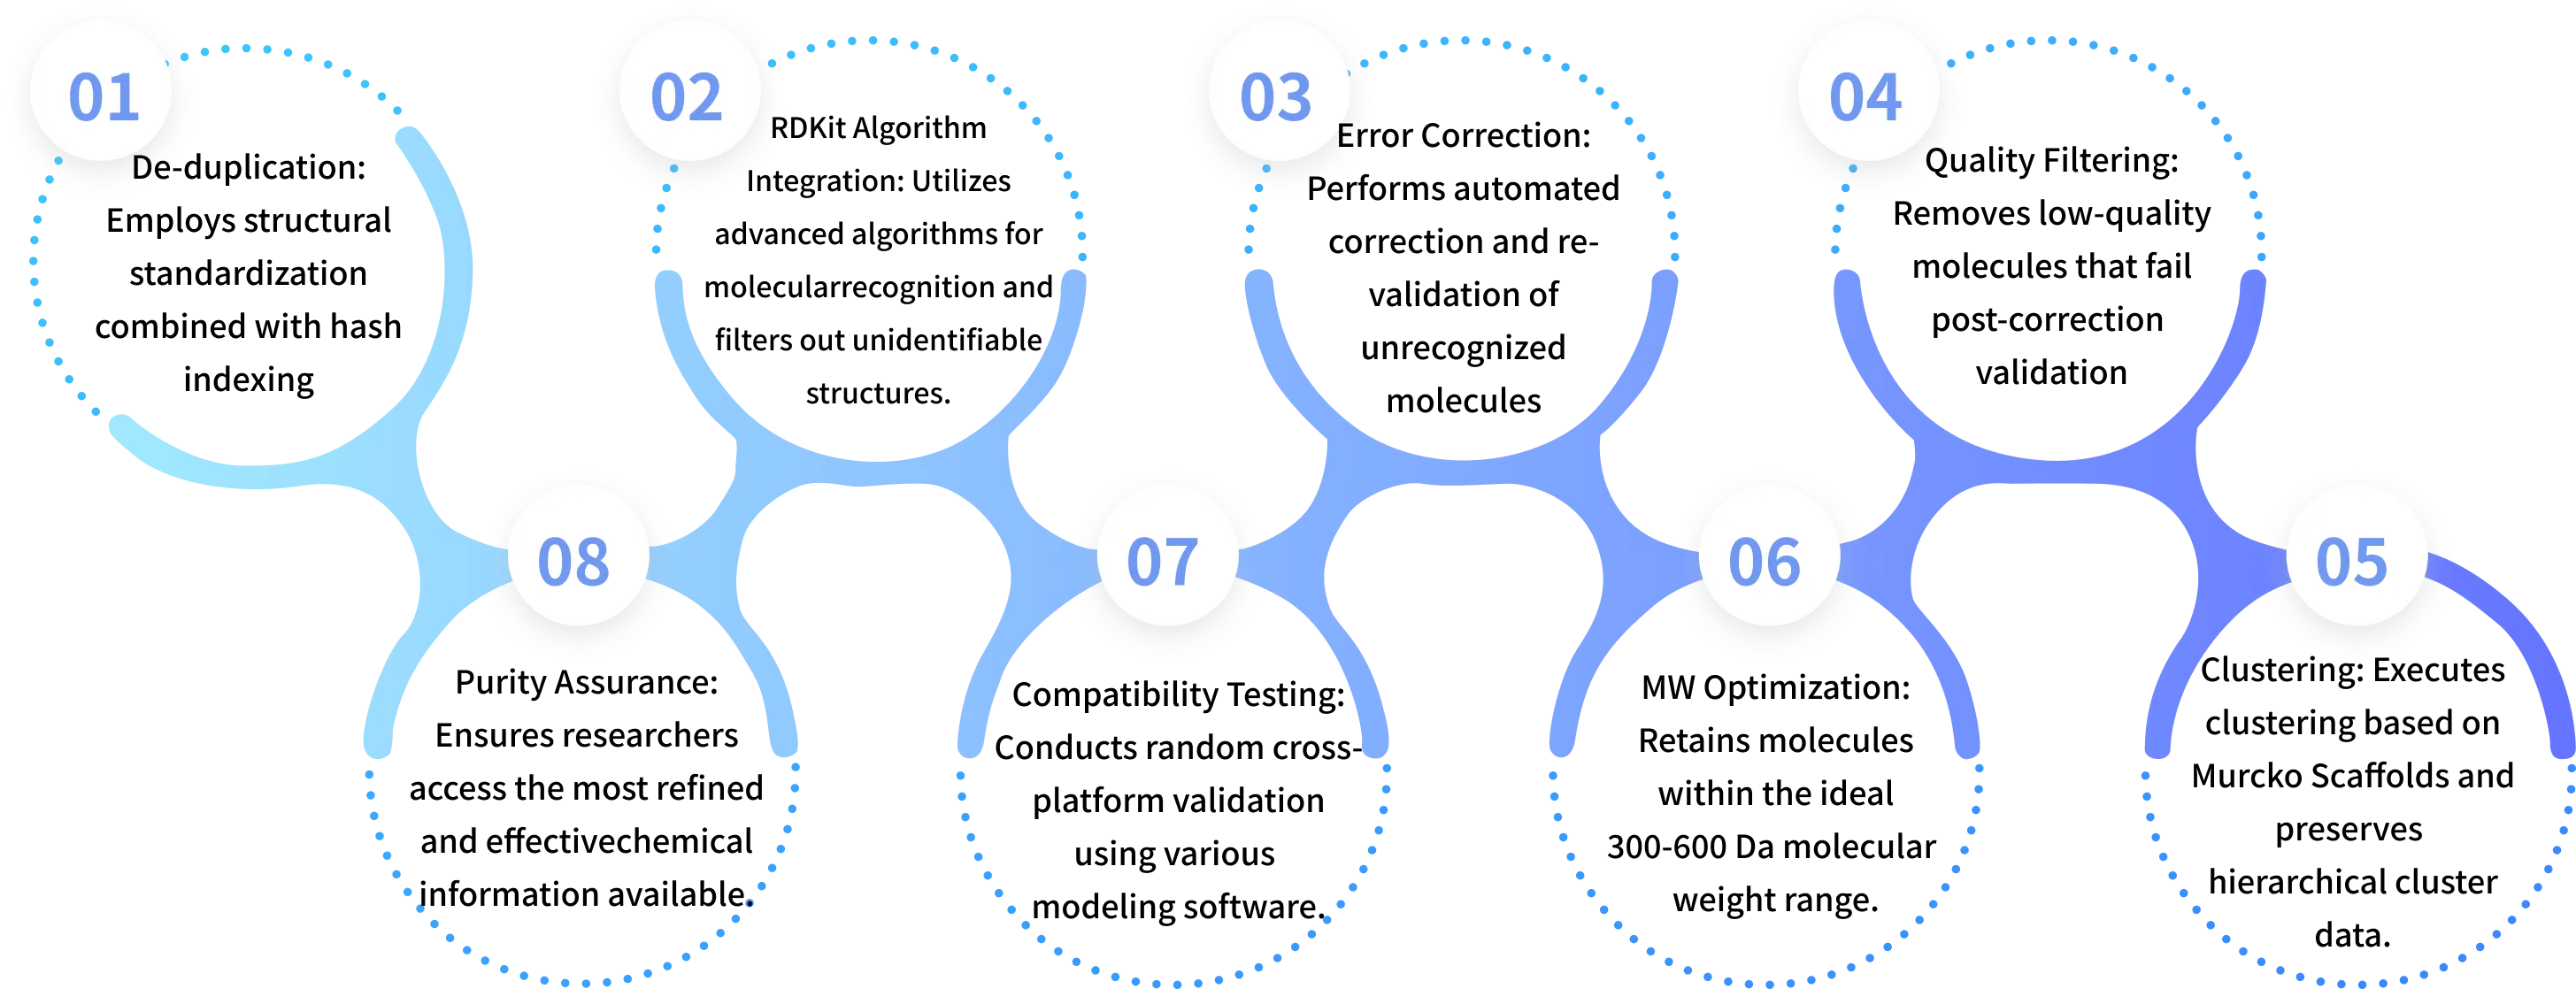
All molecules are unified in SMILES format, eliminating duplicate data to maximize computational efficiency.
Intelligent Noise Reduction
Rigorous RDKit-based screening removes unsuitable molecules to guarantee data quality.
High Compatibility
Standardized data formats ensure seamless integration with various computational chemistry and AI-driven drug discovery (AIDD) software.
AnyMol Natural Product Database
Computational Chemistry Research
Enhances efficiency in virtual screening, molecular docking, and ADMET property prediction.
AI Drug Discovery
Facilitates high-quality machine learning model training to improve drug discovery success rates.
Molecular Screening Optimization
Enables precise screening and avoids redundancy to streamline the lead discovery pipeline.
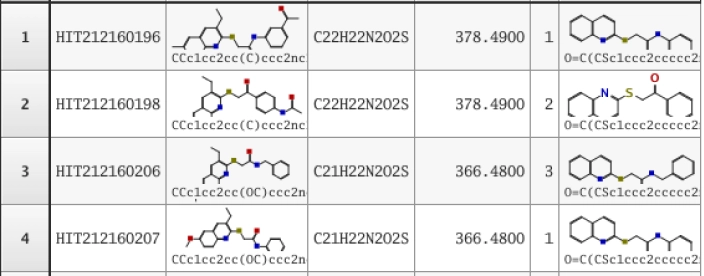
Database Construction Workflow
Loading ~